Die KI schafft plötzlich doppelt so viele ganze Aufträge. Müsst ihr jetzt umsteigen?
Anthropic und Google haben binnen zwei Tagen neue Spitzenmodelle freigegeben, und beide raten für die meiste Wissensarbeit selbst zum bisherigen Modell. Für die eigenen Vorgänge heißt das: nicht alles umstellen, sondern jeden Schritt neu besetzen.
Kaum läuft ein KI-Projekt mit einem Modell, kommt das nächste. Diese Woche gleich zwei: Der KI-Hersteller Anthropic stellte am 9. November Claude Fable 5.2 vor, Google gab einen Tag später Gemini 4 Carbon für alle frei. Wer gerade einen Vorgang an KI abgibt, fragt sich: hinterherrüsten?
Der Sprung ist echt. Der Remote Labor Index, eine Messreihe von KI-Forschern aus den USA, legt Modellen 240 echte Freelance-Aufträge vor, von der Datenauswertung bis zur Präsentation, im Schnitt knapp 29 Stunden Arbeit, und zählt, was ein Auftraggeber abnehmen würde. Ende Oktober schaffte das beste Modell gut jeden fünften. Fable 5.2 schafft laut Rangliste 41 Prozent, rund doppelt so viel.
Trotzdem raten beide Hersteller selbst zur Zurückhaltung. Anthropic empfiehlt, die meisten Wissensaufgaben weiter mit dem bisherigen Modell Opus 5.5 zu beginnen. Google nennt sein Vormodell Argon die ideale Wahl für den Großteil der Wissensarbeit.
Ein neues Spitzenmodell ist kein Grund, alles umzustellen, sondern einer, jeden Schritt eines Vorgangs neu zu besetzen.
Ein Vorgang, mehrere Modelle
Anthropic beschreibt das Muster selbst: Fable 5.2 kann als Dirigent arbeiten, der einfachere Aufgaben an kleinere Modelle abgibt. Ein bestes Modell für alles gibt es nicht: In Anthropics eigener Tabelle liegt Fable bei ganzen Aufträgen vorn, Googles Carbon bei automatisierten Geschäftsabläufen.
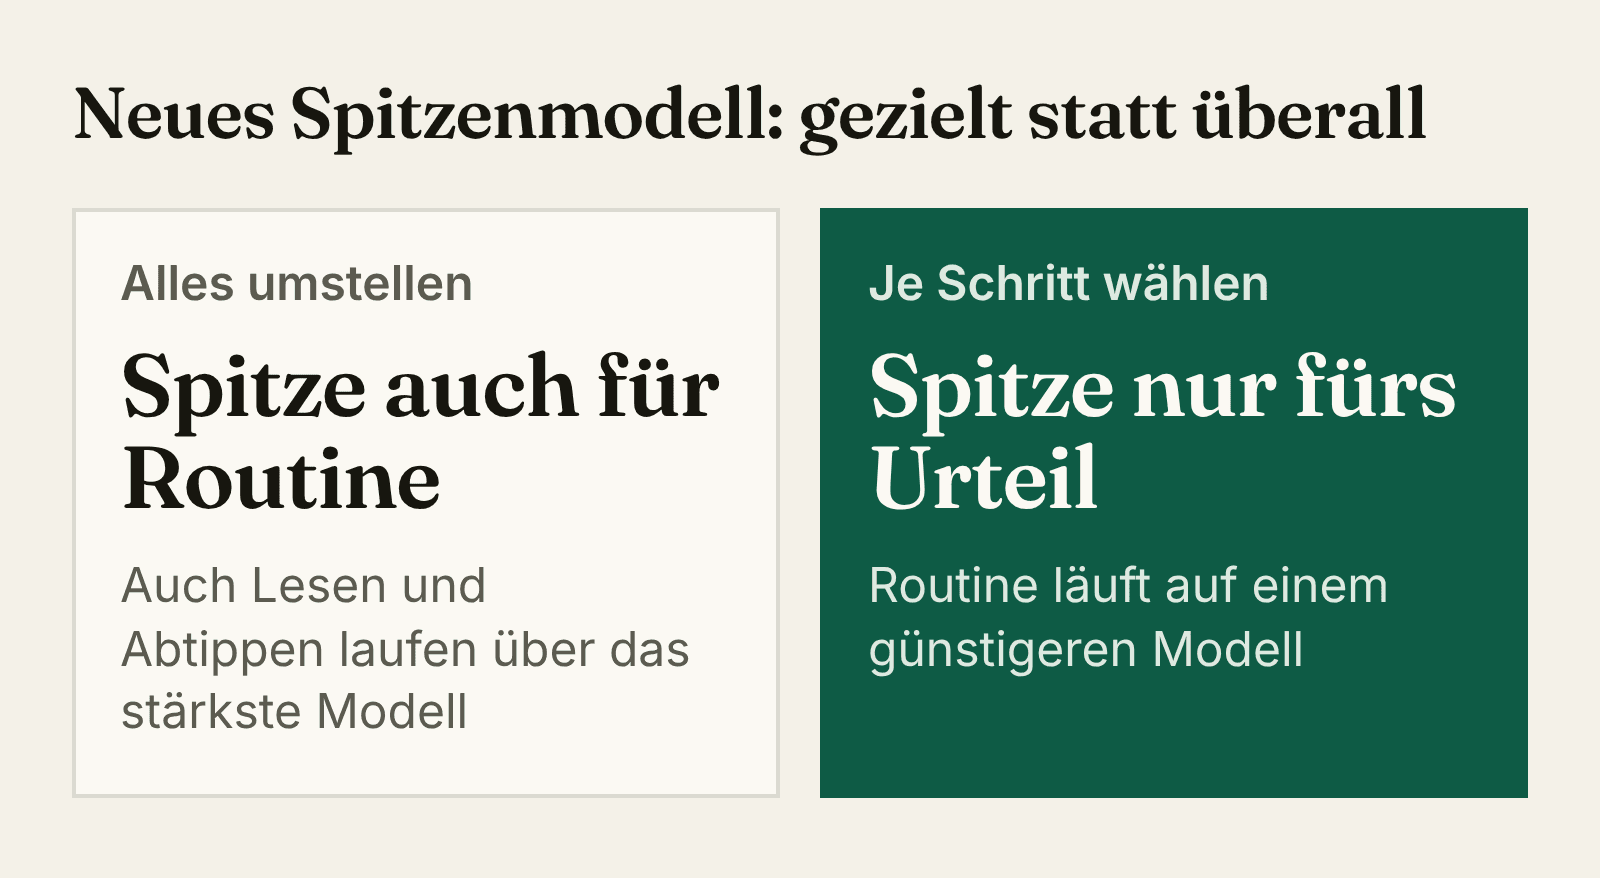
Wo sich das Spitzenmodell bei Belegen lohnt
Belege: Lesen ist Masse, Abgleichen ist Urteil
In der Buchhaltung kommen Belege per Mail, als Foto und aus Portalen, und jemand tippt sie ab.
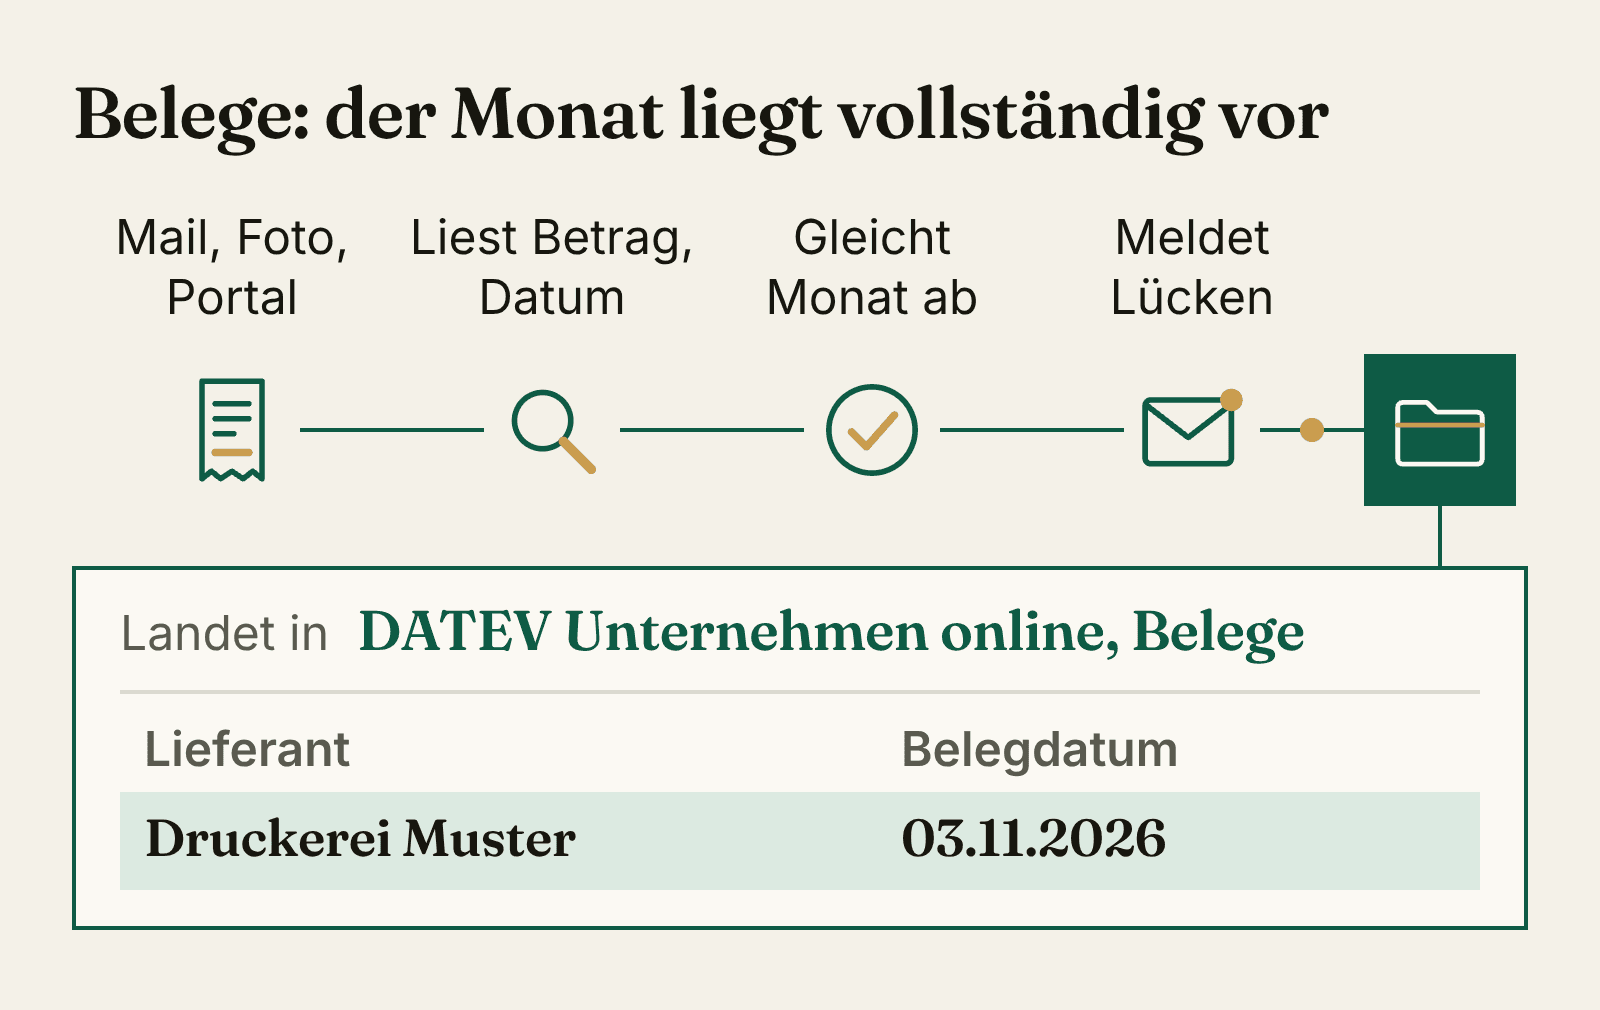
Fürs Lesen braucht es kein Spitzenmodell. Der Abgleich ist die Art Prüfung, für die Anwender das neue loben: Beim Dokumentendienst Box bemerkte es in Kreditunterlagen, dass Gehaltseingänge und Kontostand nicht zusammenpassten, so eine Kundenstimme auf der Herstellerseite. Gebucht wird weiter beim Steuerberater.
Ob ein neues Modell einen Schritt wirklich besser macht, zeigt keine Rangliste, sondern nur ein Test an echten Fällen. Die 41 Prozent messen Freelance-Aufträge, nicht eure Belegablage.
Der Wechsel bleibt Daueraufgabe
Allein Anthropic hat seit dem 22. September viermal neue Modelle vorgestellt. Jedes Mal stellt sich dieselbe Frage: Welcher Schritt wird damit genauer oder günstiger? Wer einen Vorgang an einen betriebenen Agenten abgibt, gibt diese Prüfung gleich mit ab.
Und jetzt?
Nehmt euch einen wiederkehrenden Vorgang und schreibt seine Schritte auf: wo nur gelesen und übertragen wird, und wo jemand abgleicht und entscheidet. An dieser Grenze zeigt sich, wo ein Spitzenmodell sein Geld wert ist. Das ist unsere Arbeit: Wir bauen den Agenten für euren Vorgang, betreiben ihn, wählen für jeden Schritt das Modell und stellen um, sobald ein neues es besser macht. Den ersten Schritt, eine Arbeitsprobe an einem echten Vorgang, gehen wir gern gemeinsam.