Sonnet 5.5 und GPT-6.1 Sol: Gleicher Preis, und trotzdem wird die Arbeit billiger
Ende September kamen binnen zwei Tagen zwei neue KI-Modelle, beide zum alten Listenpreis. Billiger und genauer wird trotzdem die Arbeit an Belegen und Anfragen, nur steht das auf keiner Preisliste.
Zwei neue KI-Modelle in zwei Tagen, und auf der Preisliste ändert sich nichts. Am 28. September stellte Anthropic, einer der großen US-Entwickler von KI-Modellen, Claude Sonnet 5.5 vor. Am Tag darauf folgte OpenAI, die Firma hinter ChatGPT, mit GPT-6.1 Sol. Beide kosten je Einheit genau so viel wie ihre Vorgänger. Billiger und genauer wird trotzdem die Arbeit, und das zeigt keine Preisliste.
Die Ersparnis steckt im Vorgang
Nach Angaben der Hersteller sieht der Unterschied so aus (Anthropic, OpenAI, TechCrunch):
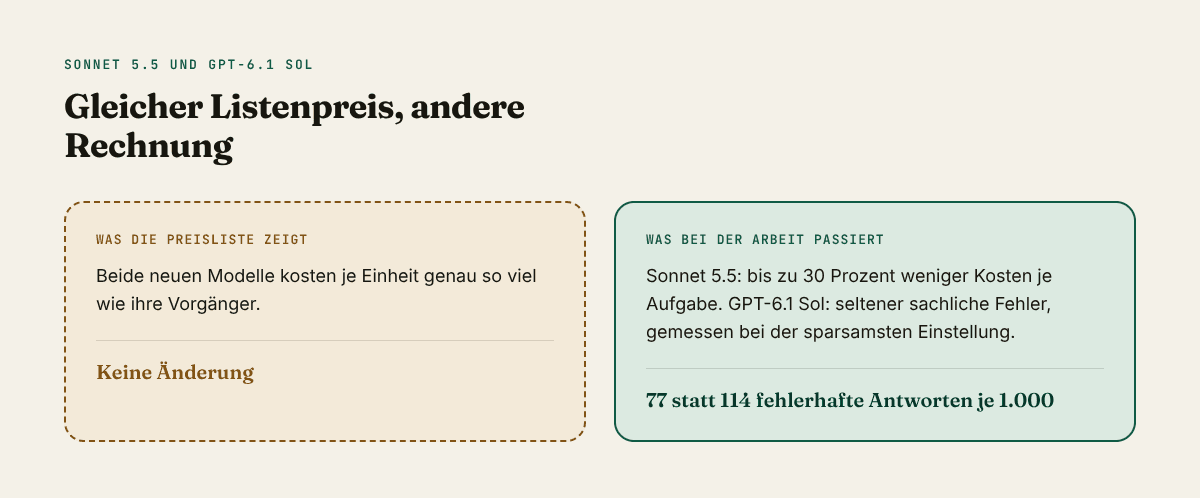
Woher die Ersparnis kommt, erklärt Anthropic selbst: Das neue Modell braucht für dieselbe Aufgabe weniger Arbeitsschritte. Was das für Vorgänge wie eure heißt, berichten drei Kunden auf der Seite des Herstellers:
- Anfragen sortieren. Ein Anbieter von Kundenservice-Software hat Hunderte echter Supportfälle durchgespielt. Das Modell traf weniger falsche Entscheidungen, die Fälle waren 20 Prozent schneller erledigt.
- Belege prüfen. Ein US-Anbieter für Dokumentenablage schreibt, das Modell gleiche Daten erneut mit dem Quelldokument ab und finde Fehler, die der Vorgänger übersah.
- Recherchieren und auswerten. Eine US-Investmentgesellschaft ließ 2.441 Finanzaufgaben rechnen, darunter das Herauslesen von Daten. Je Antwort brauchte das neue Modell rund ein Viertel der Rechenarbeit des alten.
Wer nachmisst
Der Vorgänger von GPT-6.1 Sol kam am 22. September und hatte eine Woche später schon einen Nachfolger. In diesem Takt prüft ein Betrieb mit 200 Leuten kaum nebenher, ob sich ein Wechsel für seine Belegprüfung lohnt. Geprüft werden muss es trotzdem: an echten Fällen des eigenen Vorgangs, bevor ein Agent umgestellt wird.
Die neue Generation zu kennen lohnt sich. Nachmessen muss sie, wer den Agenten betreibt.
Ein ehrlicher Vorbehalt
Alle Zahlen stammen von den Herstellern und ihren Kunden, unabhängig nachgemessen sind sie nicht. Besser im Schnitt heißt auch nicht besser bei jeder Aufgabe: Anthropic schreibt selbst, das größere Schwestermodell Opus 5.5 bleibe bei offener Arbeit, die anhaltendes Urteilsvermögen braucht, deutlich stärker.
Und jetzt?
Neue Modelle kommen inzwischen im Wochentakt, und jedes macht irgendeinen Arbeitsschritt ein Stück besser. Welches davon in eurer Belegprüfung oder eurem Postfach den Unterschied macht, müsst ihr nicht selbst verfolgen. Das ist unsere Arbeit: Wir bauen den Agenten für euren Vorgang, wählen für jeden Schritt das Modell, das bei eurem Fall am besten trägt, und stellen um, sobald ein neues es besser macht. Bei euch kommt davon nur an, dass die Arbeit schneller und günstiger erledigt ist.
Was so ein betriebener Agent kostet, steht in Was kostet ein Managed KI-Agent?. Ob er sich bei euch lohnt, zeigt sich am schnellsten an einem einzigen echten Vorgang.